Erst die Frage, dann das Verfahren
- Was ist das? (Klassifikation)
- Wo ist es? (Erkennung)
- Welche Pixel? (Segmentierung)
- Wo sind die Gelenke? (Pose)
- Was steht da? (Texterkennung)
Fünf Fragen, fünf Aufgaben. Die Frage bestimmt, wie viel Aufwand du brauchst.
Wer sagt „Wir wollen Bilderkennung“, hat noch kein Problem beschrieben. Es gibt fünf Grundfragen, und sie unterscheiden sich stark in Aufwand und Daten. Ein Projekt wird oft teurer als nötig, weil man die aufwendigere Aufgabe wählt, obwohl eine einfachere reicht.
Die Aufgaben bauen aufeinander auf: Je genauer die Antwort, desto mehr Beispiele mit mehr Arbeit brauchst du.
Ein Beispiel: Jemand sagt „Wir wollen die Qualität prüfen“. Die Rückfrage entscheidet alles. Reicht „gut“ oder „schlecht“? Dann ist es eine Klassifikation. Muss man wissen, wo der Fehler sitzt und wie groß er ist? Dann ist es eine Segmentierung. Die zweite Antwort kostet ein Vielfaches an Aufwand für die Daten.
Klassifikation: Was ist das?
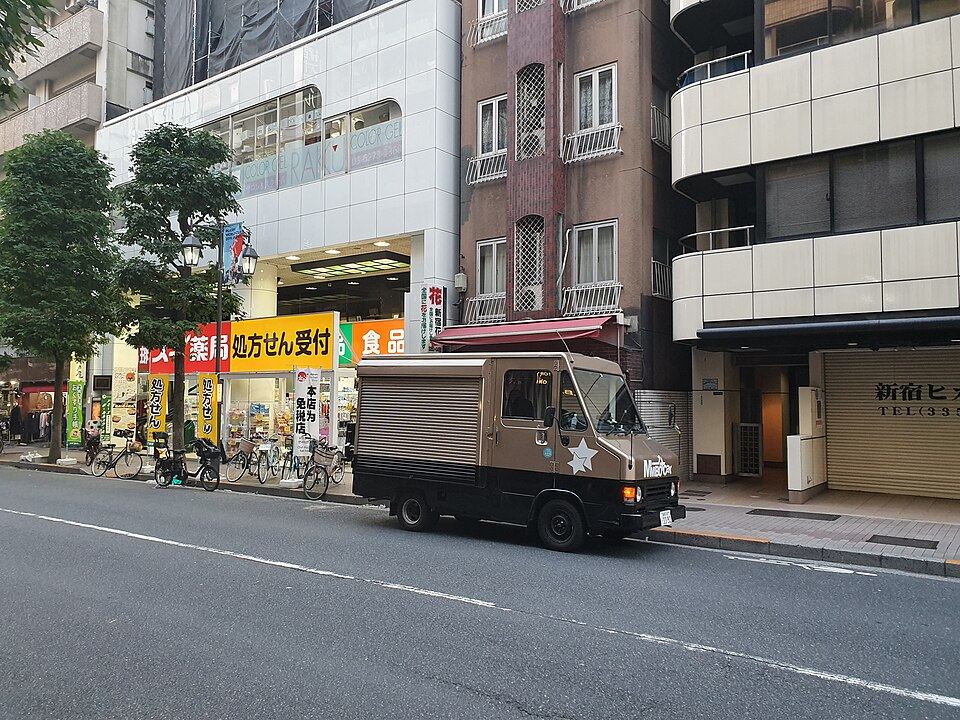
Eine Klasse für das ganze Bild, ohne Ort. Hier etwa: Lieferwagen.
Das Netz bekommt ein Bild und nennt eine Klasse für das ganze Bild, zum Beispiel „Gutteil“ oder „Ausschuss“. Es sagt nicht, wo etwas liegt. Das Anlern-Labor löst diese Aufgabe.
Beispieldaten sind einfach: ein Bild und ein Etikett (Label). Das macht diese Aufgabe zur günstigsten. Sie passt, wenn ein Bild eine Frage beantwortet und das Motiv sauber im Bild liegt.
Im Betrieb: Sichtprüfung am Band mit den Klassen „in Ordnung“ und „Ausschuss“, Vorsortieren von Fotos in Schadensmeldungen, Sortieren von Rücksendungen nach Zustand. Die Grenze: Zeigt ein Bild zwei Dinge, kann nur eine Klasse gewinnen. Und das Modell sagt nicht, woran es seine Entscheidung festmacht.
Erkennung: Wo ist es?
- Rahmen (je Objekt)
- Klasse (je Rahmen)
- Ort (im Bild)
- Anzahl (zählbar)
Das Netz liefert für jedes Objekt einen Rahmen und eine Klasse. So lässt sich zählen.
Bei der Objekterkennung liefert das Netz für jedes Objekt einen Rahmen und eine Klasse. Es kann mehrere Objekte pro Bild finden und zählen. Das Objekt-Labor zeigt es mit 80 Alltagsklassen, das Gesichts-Labor mit Gesichtern.
Die Daten sind aufwendiger: Jemand muss auf jedem Trainingsbild jedes Objekt mit einem Rahmen einzeichnen. Dafür bekommst du Position und Anzahl.
Im Betrieb: Pakete und Paletten zählen, prüfen, ob ein Helm getragen wird, Personen am Eingang zählen. Die Grenze: Verdeckte, sehr kleine oder dicht gedrängte Objekte werden übersehen oder doppelt gezählt. Wie viel Fehlalarm du in Kauf nimmst, steuerst du über die Schwelle.
Segmentierung: Welche Pixel gehören dazu?
- Links: Erkennung: Grober Rahmen, Ort und Anzahl, Rahmen einzeichnen
- Rechts: Segmentierung: Genaue Form, Fläche messbar, Umrisse nachzeichnen
Statt eines groben Rahmens bekommst du die genaue Form, aber die Etiketten kosten viel Zeit.
Die Segmentierung färbt jeden Pixel nach seiner Zugehörigkeit: Straße, Himmel, Person, Bauteil. Statt eines Rahmens bekommst du die genaue Form. Das ist wichtig, wenn Umrisse und Flächen zählen, etwa bei der Größe einer Schweißnaht oder der Fläche eines Schadens.
Die Daten sind am teuersten: Jemand muss die Umrisse sauber nachzeichnen. Das dauert je Bild deutlich länger als ein Rahmen.
Im Betrieb: Flächen von Schäden oder Rissen ausmessen, Produktfotos freistellen, bei Robotern befahrbare von nicht befahrbaren Flächen trennen. Die Grenze: Die Qualität hängt stark davon ab, wie sauber die Umrisse im Training gezeichnet waren.
Pose und Texterkennung
- Links: Pose: Schultern, Ellbogen, Knie, Strichmännchen, Haltung, Heben, Sturz
- Rechts: Texterkennung: Schrift wird Text, Gedruckt klappt gut, Beträge gegenprüfen
Pose liest Gelenkpunkte, Texterkennung liest Schrift. Beide liefern nur Wahrscheinlichkeiten.
Die Posenschätzung sucht Schlüsselpunkte am Körper: Schultern, Ellbogen, Hüften, Knie. Verbindet man sie, entsteht ein Strichmännchen. Daraus lässt sich lesen, ob sich jemand bückt, hebt oder fällt. Die Gesichter selbst werden dafür nicht gebraucht.
Die Texterkennung (englisch OCR) wandelt Schrift im Bild in Text. Gedruckte Schrift auf geradem, hellem Grund gelingt meist gut. Handschrift, Knicke, Spiegelungen und schlechte Fotos machen sie schwerer.
Im Betrieb: Haltung am Arbeitsplatz einschätzen, Stürze erkennen, Bewegungen im Sport analysieren. Lieferscheine und Rechnungen einlesen, Kennzeichen am Tor lesen. Die Grenze: Beide Verfahren arbeiten mit Wahrscheinlichkeiten. Eine falsch gelesene Ziffer auf einer Rechnung fällt nicht von selbst auf, darum prüfst du Beträge gegen eine zweite Quelle.
Alle fünf im Vergleich
- Segmentierung (Umrisse nachzeichnen)
- Pose (Punkte je Person)
- Erkennung (Rahmen je Objekt)
- Texterkennung (oft fertige Modelle)
- Klassifikation (Bild plus Klasse)
Je weiter oben, desto aufwendiger sind Etiketten, Rechenzeit und Pflege.
Die Tabelle stellt die Aufgaben nebeneinander. Die Angaben zum Aufwand sind relativ gemeint: Eine Zeile ist aufwendiger als die darüber.
| Aufgabe | Frage | Ergebnis | Daten und Etiketten | Aufwand |
|---|---|---|---|---|
| Klassifikation | Was ist das? | Eine Klasse je Bild | Bild plus Klasse | niedrig |
| Erkennung | Wo ist es, wie viele? | Rahmen mit Klasse | Rahmen je Objekt einzeichnen | mittel |
| Segmentierung | Welche Pixel gehören dazu? | Maske je Klasse oder Objekt | Umrisse nachzeichnen | hoch |
| Pose | Wo sind die Gelenke? | Schlüsselpunkte | Punkte je Person markieren | mittel bis hoch |
| Texterkennung | Was steht da? | Text, oft mit Position | Zeilen und Zeichen | mittel, oft fertige Modelle |
Welche Aufgabe passt zu meinem Problem?
- Ganzes Bild? (Klassifikation)
- Zählen, orten? (Erkennung)
- Form zählt? (Segmentierung)
- Haltung? (Pose)
- Schrift? (Texterkennung)
Die Fragen der Reihe nach stellen. Die erste, die dein Problem löst, gewinnt.
Gehe die Fragen in dieser Reihenfolge durch. Nimm die erste, die dein Problem löst.
- Reicht ein Ja oder Nein oder eine Klasse für das ganze Bild? Dann Klassifikation. Beispiel: Ist das Teil in Ordnung?
- Musst du zählen oder wissen, wo etwas liegt? Dann Erkennung. Beispiel: Wie viele Paletten stehen im Feld?
- Zählt die genaue Form oder Fläche? Dann Segmentierung. Beispiel: Wie groß ist der Lackschaden?
- Geht es um Körperhaltung und Bewegung? Dann Pose. Beispiel: Wird beim Heben der Rücken gerade gehalten?
- Soll Schrift weiterverarbeitet werden? Dann Texterkennung. Beispiel: Lieferschein in die Warenwirtschaft.
Datenschutz und Grenzen im Einsatz
- Links: Bild aufbewahren: Personen erkennbar, Mehr Risiko, Mehr Pflichten
- Rechts: Nur Zählwert: Am Gerät auswerten, Bild sofort verwerfen, Weniger Risiko
Alle fünf Aufgaben können Personenbezug haben. Prüfe, ob ein Zählwert statt des Bildes reicht.
Jede der fünf Aufgaben kann Personenbezug haben. Erkennung zählt Personen, Pose beobachtet Bewegungen, Texterkennung liest Namen, Adressen und Kennzeichen. Auch ohne Gesicht kann eine Person über Kleidung, Ort und Zeit erkennbar sein.
Fragen vor dem Einsatz: Reicht ein Zählwert statt des Bildes? Kann die Auswertung am Gerät laufen und das Bild sofort verworfen werden? Wer erfährt von der Kamera? Das ist ein Überblick, keine Rechtsberatung.
Alle fünf Aufgaben liefern Wahrscheinlichkeiten, keine Gewissheit. Plane einen Menschen für unsichere und folgenreiche Fälle ein.